家里的NAS是ESXi上跑的群晖虚拟机(黑裙),主板的Intel SATA控制器直通给它,挂了四块硬盘。这一年里它莫名其妙掉盘了六次:直通控制器上的四块盘同一秒一起掉盘,存储池直接crashed,重启一下又全好了。有时候隔3天,有时候隔半年多,完全摸不着规律。
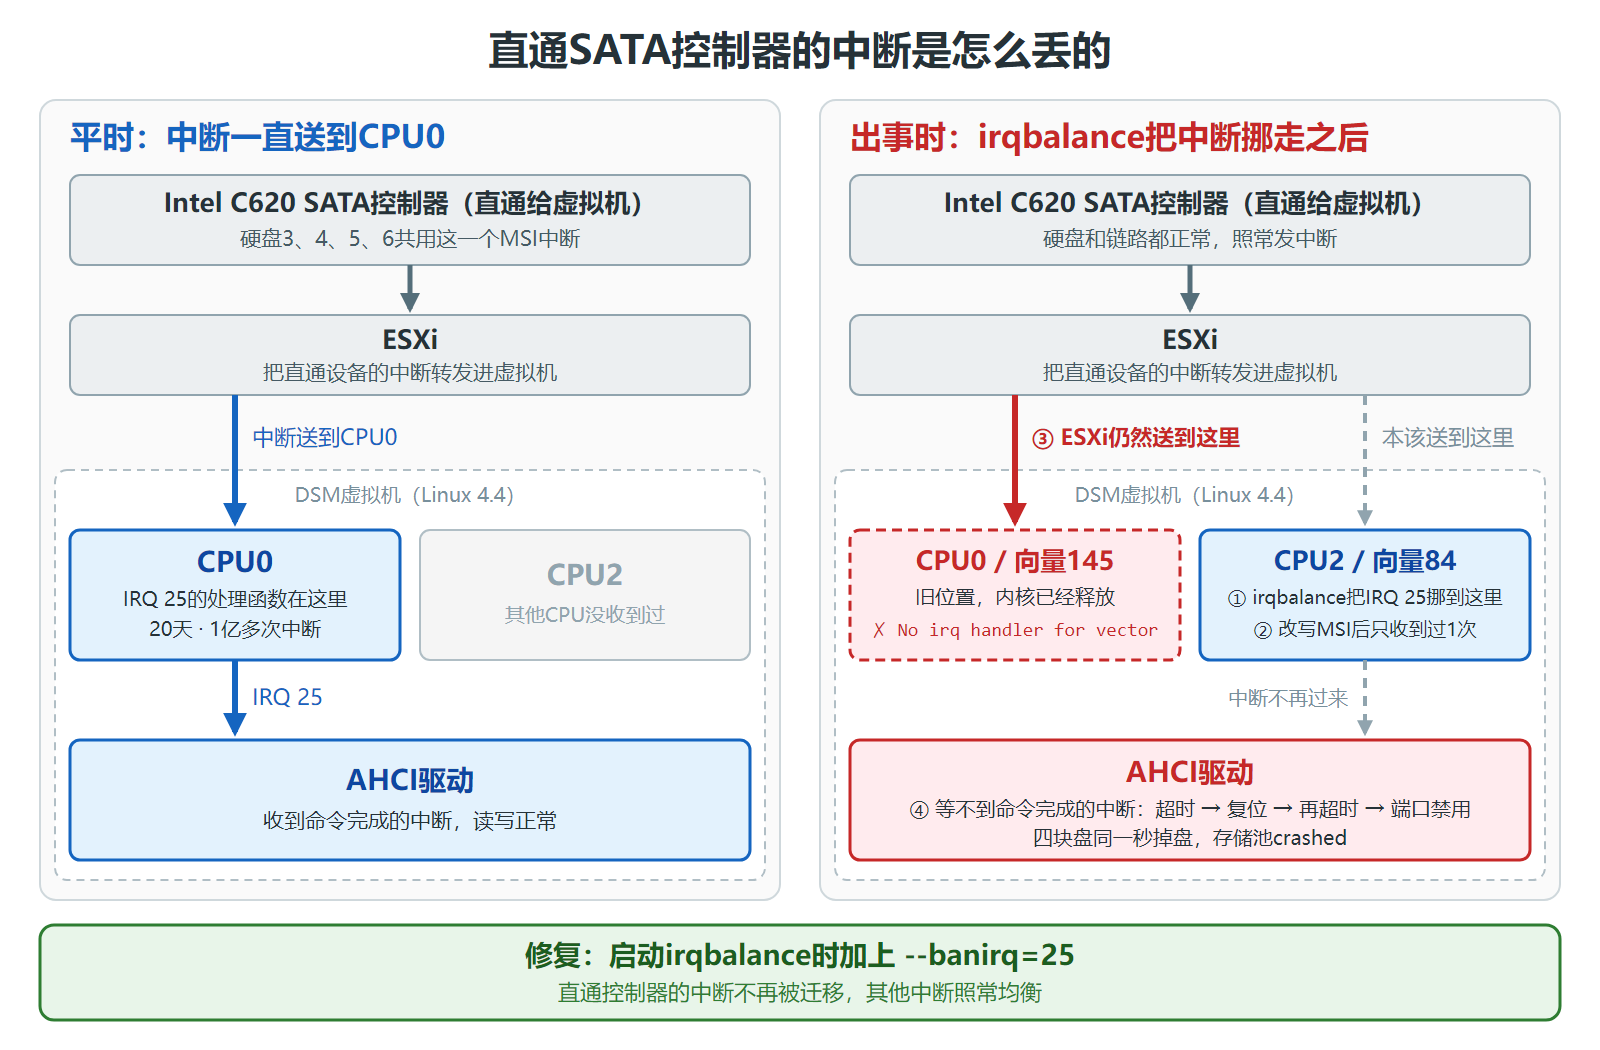
之前每次都是重启了事,这次忍住没重启,登进去看了内核日志。结果硬盘和线都没毛病,是DSM自带的irqbalance想把直通控制器的中断挪到别的CPU上。真机上设备会照办,可ESXi直通的时候根本不理会这个改动,中断还是往开机时的位置送。内核这边一直留着旧位置所以没事,直到某一天把它释放了(do_IRQ: 0.145 No irq handler for vector),驱动再也收不到中断,四块盘的命令全部超时,最后被内核一个个禁用。
解决办法是启动irqbalance的时候加个--banirq,不让它动这个中断。改完重启,两分钟后NAS回来,存储池自己就组好了。下面记一下过程。
环境
| 部分 | 配置 |
|---|---|
| 宿主机 | ESXi 8.0 U3(8.0.3 build 24859861),Xeon Silver 4210R,Intel C620芯片组的主板 |
| 虚拟机 | DSM 7.4.1-90080 Update 1,型号配置RS1221+,内核4.4.302+,8 vCPU |
| 硬盘1、2 | VMware虚拟磁盘,挂在虚拟SATA控制器上。存储池1(RAID 1),放Docker和套件 |
| 硬盘3~6 | 主板的Intel C620 SATA控制器(AHCI,8086:a182)直通进来。三块12TB组的存储池2(SHR),还有一块1TB没进池 |
DSM的系统分区在每块盘上都有一份,所以直通的盘全掉了系统也还活着,网页能开,/var/log也还在。
问题现象
- 存储管理器里存储池2显示已损毁,HDD/SSD里只剩两块虚拟盘。
- 通知里有一条
Drive slot has been disabled. - 存储池1上的Docker容器没受影响,存储池2上的共享文件夹全挂了。
DSM的日志(系统日志和硬盘日志按时间放一起了,都是原文):
1 2 3 4 5 6 7 8 9 | 2026/11/10 19:46:34 err A write error occurred at sector [8200] on [Drive 3] (Serial number: [ ]). 2026/11/10 19:46:38 err A write error occurred at sector [8] on [Drive 5] (Serial number: [ ]). 2026/11/10 19:46:40 info Drive 4 DT01ACA100 Drive plugged out. 2026/11/10 19:46:40 info Drive 3 WD120EFGX-68CPHN0 Drive plugged out. 2026/11/10 19:46:40 info Drive 5 WD120EDBZ-11B1HA0 Drive plugged out. 2026/11/10 19:46:40 info Drive 6 MG07ACA12TEY Drive plugged out. 2026/11/10 19:46:41 err Storage Pool [2] crashed. 2026/11/10 19:46:41 err A write error occurred at sector [8200] on [Drive 6] (Serial number: [ ]). 2026/11/10 19:46:49 err Drive -1 - Drive slot has been disabled. |
四块盘是同一秒掉盘的。
往前翻了下日志,同样的掉盘一共六次:
| 掉盘时间(UTC) | 距上一次 | 怎么恢复的 |
|---|---|---|
| 2025-11-06 12:16 | — | 重启 |
| 2025-12-27 23:05 | 51天 | 重启 |
| 2026-03-02 04:16 | 65天 | 重启 |
| 2026-03-29 21:09 | 27天 | 重启 |
| 2026-04-01 17:13 | 3天 | 重启 |
| 2026-11-10 19:46 | 223天 | 这次 |
四块盘是两个牌子四个型号,不可能同一秒一起坏,两块虚拟盘又从来没事,所以肯定不是硬盘本身的问题,得往控制器、直通或者供电上找。
SSH也登不上了
想登进去看日志,结果密钥登录直接被拒:
1 | Permission denied (publickey,password). |
密钥没问题,ssh -v能看到公钥发过去了,就是服务器不认。想了一下才反应过来:homes共享文件夹在存储池2上,authorized_keys跟着一起没了(
root的家目录在系统分区,不受影响。用密码登上去sudo -i,把公钥加到root下面就能用密钥登root了:
1 2 3 | mkdir -p /root/.ssh && chmod 700 /root/.ssh echo 'ssh-ed25519 AAAA...(你自己的公钥)' >> /root/.ssh/authorized_keys chmod 600 /root/.ssh/authorized_keys |
这时候先别重启。重启存储池是能回来,但/proc/interrupts这些现场就没了,这次能查出来全靠它。另外存储池挂了以后btrfs会疯狂往kern.log里刷报错,我这一小时刷了二十多万行,日志只留9份,出事那几分钟的记录过几个小时就被冲掉了,最好先另存一份。
背景知识
看日志之前先说几个东西,熟悉的可以直接跳过。
中断(IRQ)是硬件有事通知CPU的方式。比如硬盘控制器把一个读写命令做完了,就发一个中断,内核里的驱动(这里是AHCI驱动)收到了才知道命令完成。驱动发完命令就在等这个中断,等不到就只能超时。
/proc/interrupts里每一行是一个中断号,后面是每个CPU处理过多少次,最后是哪个设备的。
以前PCI设备的中断是走专门的中断线的(INTx),几个设备可能共用一根线,再经过IOAPIC转给CPU。现在的PCI设备基本都改用MSI(Message Signaled Interrupts)了,不用中断线,设备要发中断的时候就往一个特定的地址写一个数,这次写操作本身就是中断。
这个地址和数就存在设备的配置空间里,是驱动加载的时候内核给设的。x86上地址是0xfeeXXXXX这种,里面带着目标CPU的APIC ID,数据里是向量号(vector)。每个CPU有一张向量表,内核在里面登记哪个向量归哪个中断处理。所以一个MSI中断送到哪个CPU的哪个向量,就是设备里这两个值说了算,lspci -vv能看到。后面日志里的0.145就是CPU 0的145号向量。
一个中断由哪个CPU处理叫affinity,是可以改的。irqbalance是个后台程序,隔一会儿看一下各个CPU的中断负载,把中断在CPU之间挪来挪去,让负载平均一点。挪一个MSI中断的时候,内核要在新的CPU上分一个新向量,再把设备里的地址和数据改掉。
地址和数据是两个寄存器,要分两次写。有的设备支持MSI屏蔽(MSI-X是每个中断都自带屏蔽位),改之前可以先把中断挡住,改完再放开。不支持的(lspci里显示Maskable-)只能直接改,改到一半设备正好发中断的话,就可能送错地方。
直通是ESXi把物理设备直接交给虚拟机用,虚拟机里的驱动直接操作这个设备。不过中断怎么送进虚拟机是ESXi管的,它按虚拟机给设备设的目标(哪个CPU、哪个向量)来送。所以虚拟机里改了MSI的目标,ESXi那边也得跟着改。
内核日志
四块盘一起掉盘,能想到的大概三种情况,日志里的样子不一样:
| 可能的原因 | 内核日志里会看到什么 |
|---|---|
| 直通控制器的中断丢了 | 命令超时,复位后链路能正常up,但接着的IDENTIFY又超时 |
| 控制器从PCI总线上掉了(ESXi那边的问题) | controller reset failed,寄存器读回来全是1 |
| 四块盘共用的供电、线或者背板 | 所有端口一起SATA link down |
然后看/var/log/kern.log里出事那几分钟。去掉了主机名和内核时间戳,箭头后面是我加的说明,ata35~ata38是直通控制器上的硬盘3~6:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | 19:42:52 do_IRQ: 0.145 No irq handler for vector ← 最早的一条异常 19:42:52 do_IRQ: 0.145 No irq handler for vector 19:42:52 do_IRQ: 0.145 No irq handler for vector 19:42:56 do_IRQ: 0.145 No irq handler for vector 19:43:17 ata36.00 : exception Emask 0x0 SAct 0x0 SErr 0x0 action 0x6 frozen 19:43:17 ata36.00 : failed command: READ LOG EXT ← 第一个超时的命令 19:43:17 ata36 : hard resetting link 19:43:18 ata36 : SATA link up 6.0 Gbps (SStatus 133 SControl 300) ← 复位后链路马上就好了 19:43:18 do_IRQ: 0.145 No irq handler for vector ← 控制器发了中断,又没人接 19:43:18 do_IRQ: 0.145 No irq handler for vector 19:43:28 ata36.00 : qc timeout (cmd 0xec) ← IDENTIFY 等了 10 秒没等到中断 19:43:28 ata36.00 : failed to IDENTIFY (I/O error, err_mask=0x4) 19:43:28 ata36 : hard resetting link 19:43:28 ata36 : SATA link up 6.0 Gbps (SStatus 133 SControl 300) 19:43:54 ata35.00 : exception Emask 0x0 SAct 0xfff00 SErr 0x0 action 0x6 frozen 19:43:54 ata35.00 : failed command: WRITE FPDMA QUEUED ← 第二块盘,队列里 12 个命令一起超时 19:44:52 ata37.00 : failed command: FLUSH CACHE EXT ← 第三、第四块盘 19:44:52 ata38.00 : failed command: FLUSH CACHE EXT ……中间每个端口都是一样的:复位、link up、IDENTIFY 超时 19:44:58 ata36.00 : disabled ← 重试完了,内核放弃这个端口 19:44:58 ata36 : send port disabled event ← DSM 日志里的 Drive slot has been disabled 就是它 19:45:35 ata35.00 : disabled 19:45:35 md/raid:md3: Disk failure on sata3p5, disabling device. 19:46:34 ata37.00 : disabled 19:46:34 ata38.00 : disabled 19:46:34 md/raid:md3: Disk failure on sata5p5, disabling device. ← RAID 5 掉了第二块,存储池 crashed |
可以看到:
SErr是0,每次复位链路都能6.0 Gbps重新up,不是供电和线的问题。后来看SMART,四块盘的UDMA_CRC_Error_Count也都是0。- 没有
controller reset failed,控制器一直都在。 - 命令能发出去,就是等不到命令完成的中断。这几分钟里
No irq handler for vector一共36条,全是0.145,每次复位完都会出现两条。
0.145是CPU 0的145号向量,意思是有中断送到了这里,但内核在这个位置没有登记处理函数。
中断去哪了
因为没重启,现场都还在。先确认直通控制器用的是哪个中断。lspci里能看到两个SATA控制器,13:00.0是直通进来的Intel控制器(DeviceName是pciPassthru0),中断号在sysfs里:
1 2 3 4 5 6 7 8 9 10 11 12 13 | # lspci -nnk | grep -A3 'SATA controller' 02:02.0 SATA controller [0106]: VMware SATA AHCI controller [15ad:07e0] DeviceName: sata0 Subsystem: VMware SATA AHCI controller [15ad:07e0] Kernel driver in use: ahci -- 13:00.0 SATA controller [0106]: Intel Corporation C620 Series Chipset Family SATA Controller (AHCI) [8086:a182] (rev 09) DeviceName: pciPassthru0 Subsystem: ASUSTeK Computer Inc. Device [1043:871e] Kernel driver in use: ahci # cat /sys/bus/pci/devices/0000:13:00.0/irq 25 |
所以是IRQ 25。中断号是开机的时候分配的,不是固定的,后面的脚本也是这样现查。
再看/proc/interrupts(中间几列省略了),25那一行最后一列也是这个PCI地址:
1 2 3 | CPU0 CPU1 CPU2 CPU3 ... CPU7 24: 11328005 23815479 18325763 18396953 ... 13706818 PCI-MSI 1081344-edge 0000:02:02.0 ← 虚拟 SATA 控制器 25: 104491346 0 1 0 ... 0 PCI-MSI 9961472-edge 0000:13:00.0 ← 直通的 Intel 控制器 |
开机20天,直通控制器(IRQ 25)一亿多次中断全在CPU0上,CPU2上有1次,其他都是0。再看几个地方:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # cat /proc/irq/25/smp_affinity_list 6 # lspci -vv -s 13:00.0 | grep -A1 'MSI:' Capabilities: [80] MSI: Enable+ Count=1/1 Maskable- 64bit- Address: fee04000 Data: 4054 # grep -E '^(processor|apicid)' /proc/cpuinfo | paste - - processor : 0 apicid : 0 processor : 1 apicid : 2 processor : 2 apicid : 4 …… # ps -eo pid,lstart,args | grep irqbalance 12795 Wed Oct 21 19:17:29 2026 /usr/sbin/irqbalance |
- MSI的Address是
fee04000,目标APIC ID是4,这台虚拟机里对应CPU2;Data是0x4054,向量是0x54也就是84。就是说内核已经把这个设备的MSI改成了送到CPU2的84号向量。 - CPU2上确实收到过1次,但之后的中断全跑到CPU0的145号向量去了,和设备里写的对不上。
- affinity是6,是irqbalance后来又想把它挪到CPU6。这种MSI改affinity要等下一次中断来的时候才真正执行,结果中断再也没来。
Maskable-,这个控制器的MSI不支持屏蔽。- 改affinity的就是irqbalance,DSM自带的,开机就在跑。
到这里能确定的是:设备里写的目标是CPU2 / 84,实际中断送到的是CPU0 / 145,而CPU0的145号向量内核已经不认了。但还有两件事说不通:群晖真机上irqbalance天天这么挪中断,为什么没事?IRQ 25在CPU0上好好跑了20天,又是什么时候出的问题?
为什么真机没事,ESXi上就不行
先去看了ESXi那边。虚拟机的vmware.log和主机的vmkernel.log在19:42那会儿关于这个设备一行都没有,只有虚拟机重启的时候才有几行直通设备的记录。也就是说虚拟机改MSI这件事,ESXi根本没当回事。
再看ESXi是怎么送这个中断的:
1 2 3 4 5 6 | # zcat /var/run/log/vmkernel.2.gz | grep iovEnablePostedIntr 2026-09-07T00:36:20Z In(182) vmkernel: TSC: 560494 cpu0:1)BootConfig: 783: iovEnablePostedIntr = TRUE (1) 2026-09-29T17:21:53Z In(182) vmkernel: TSC: 556738 cpu0:1)BootConfig: 783: iovEnablePostedIntr = TRUE (1) # vsish -e get /hardware/iov/vtd/units/0/info | grep Posted Posted Interrupts Enabled:1 |
ESXi开了posted interrupt,直通设备的中断不经过ESXi的软件,是硬件按一张表直接送到虚拟机的某个CPU和向量上,这张表是ESXi填的。那就要看虚拟机改写MSI以后,ESXi会不会跟着改这张表。
直接做了个实验(这时候已经重启过,IRQ 25在CPU0的145号向量上):一边用dd读盘制造中断,一边在虚拟机里把直通控制器的MSI数据寄存器从向量145改成231,保持50毫秒再改回去,看这50毫秒里中断还到不到CPU0。脚本的输出:
1 2 3 4 5 6 7 | mode=data hold=50 ms uptime_at_start=5808.51 registers before : 057001000000e0fe9140 read back in hold: e740 registers after : 057001000000e0fe9140 restored=True irq 25 per-CPU deltas baseline window: [1383, 0, 0, 0, 0, 0, 0, 0] irq 25 per-CPU deltas rewrite window : [1489, 0, 0, 0, 0, 0, 0, 0] irq 25 per-CPU deltas after restore : [1491, 0, 0, 0, 0, 0, 0, 0] |
寄存器确实改掉了(读回来是e7,也就是231),但这50毫秒里1489次中断照样送到了CPU0,一次都没丢。把地址寄存器(目标CPU)从CPU0改成CPU7也一样(只留了相关的行):
1 2 3 4 5 | mode=addr hold=50 ms uptime_at_start=5819.41 read back in hold: 00e0e0fe irq 25 per-CPU deltas baseline window: [1377, 0, 0, 0, 0, 0, 0, 0] irq 25 per-CPU deltas rewrite window : [1537, 0, 0, 0, 0, 0, 0, 0] irq 25 per-CPU deltas after restore : [1518, 0, 0, 0, 0, 0, 0, 0] |
所以ESXi完全不理会虚拟机对MSI的改写,中断一直送到虚拟机开MSI的时候(也就是开机时)的那个CPU和向量。真机上没有这一层,设备自己的寄存器改了马上就生效,irqbalance怎么挪都没事。
这个实验有风险。如果ESXi认了改写,这50毫秒里的中断就全丢了,轻则卡几十秒,重则再掉一次盘,别在有数据的机器上随便试。
那为什么还能跑20天
4.4内核挪中断的时候不会马上丢掉旧向量,要等新位置上收到第一个中断,才认为挪完了,再把旧向量释放掉。ESXi一直往旧位置送,旧向量一直有效,所以一切正常,只是smp_affinity里显示的CPU和实际收中断的CPU对不上而已。这个状态可以一直持续下去。
直到新位置上真的来了一个中断,/proc/interrupts里CPU2上那孤零零的1次就是它。这个中断多半不是直通控制器发的,而是虚拟SATA控制器(IRQ 24)的:它的MSI也不能屏蔽,irqbalance大概每30秒就挪它一次,挪的时候内核先写地址再写数据,中间要是正好来了一个中断,就会送到新的CPU、旧的向量上。平时日志里那些零星的No irq handler就是这么来的。
写了个脚本记录IRQ 24的MSI寄存器每次变化的时间(开机后的秒数),和内核日志对上了两条:
1 2 3 4 5 6 7 | 5069.02 apic=8 vec=47 raw=0080e0fe000000002f40 ← IRQ 24在CPU4,向量47 5101.84 apic=4 vec=63 raw=0040e0fe000000003f40 ← 挪到CPU2,向量63 [ 5101.991198] do_IRQ: 2.47 No irq handler for vector ← 新的CPU(2),旧的向量(47) 5500.31 apic=4 vec=97 raw=0040e0fe000000006140 ← IRQ 24在CPU2,向量97 5509.18 apic=0 vec=129 raw=0000e0fe000000008140 ← 挪到CPU0,向量129 [ 5509.342965] do_IRQ: 0.97 No irq handler for vector ← 新的CPU(0),旧的向量(97) |
这种送错的中断落在没人用的向量上,就是一条No irq handler,没什么影响。可要是正好落在IRQ 25预留的新位置(CPU2的84号向量)上,内核就以为IRQ 25挪完了,把CPU0上的旧向量释放掉,而ESXi还在往旧位置送,后面真正的中断就全丢了。
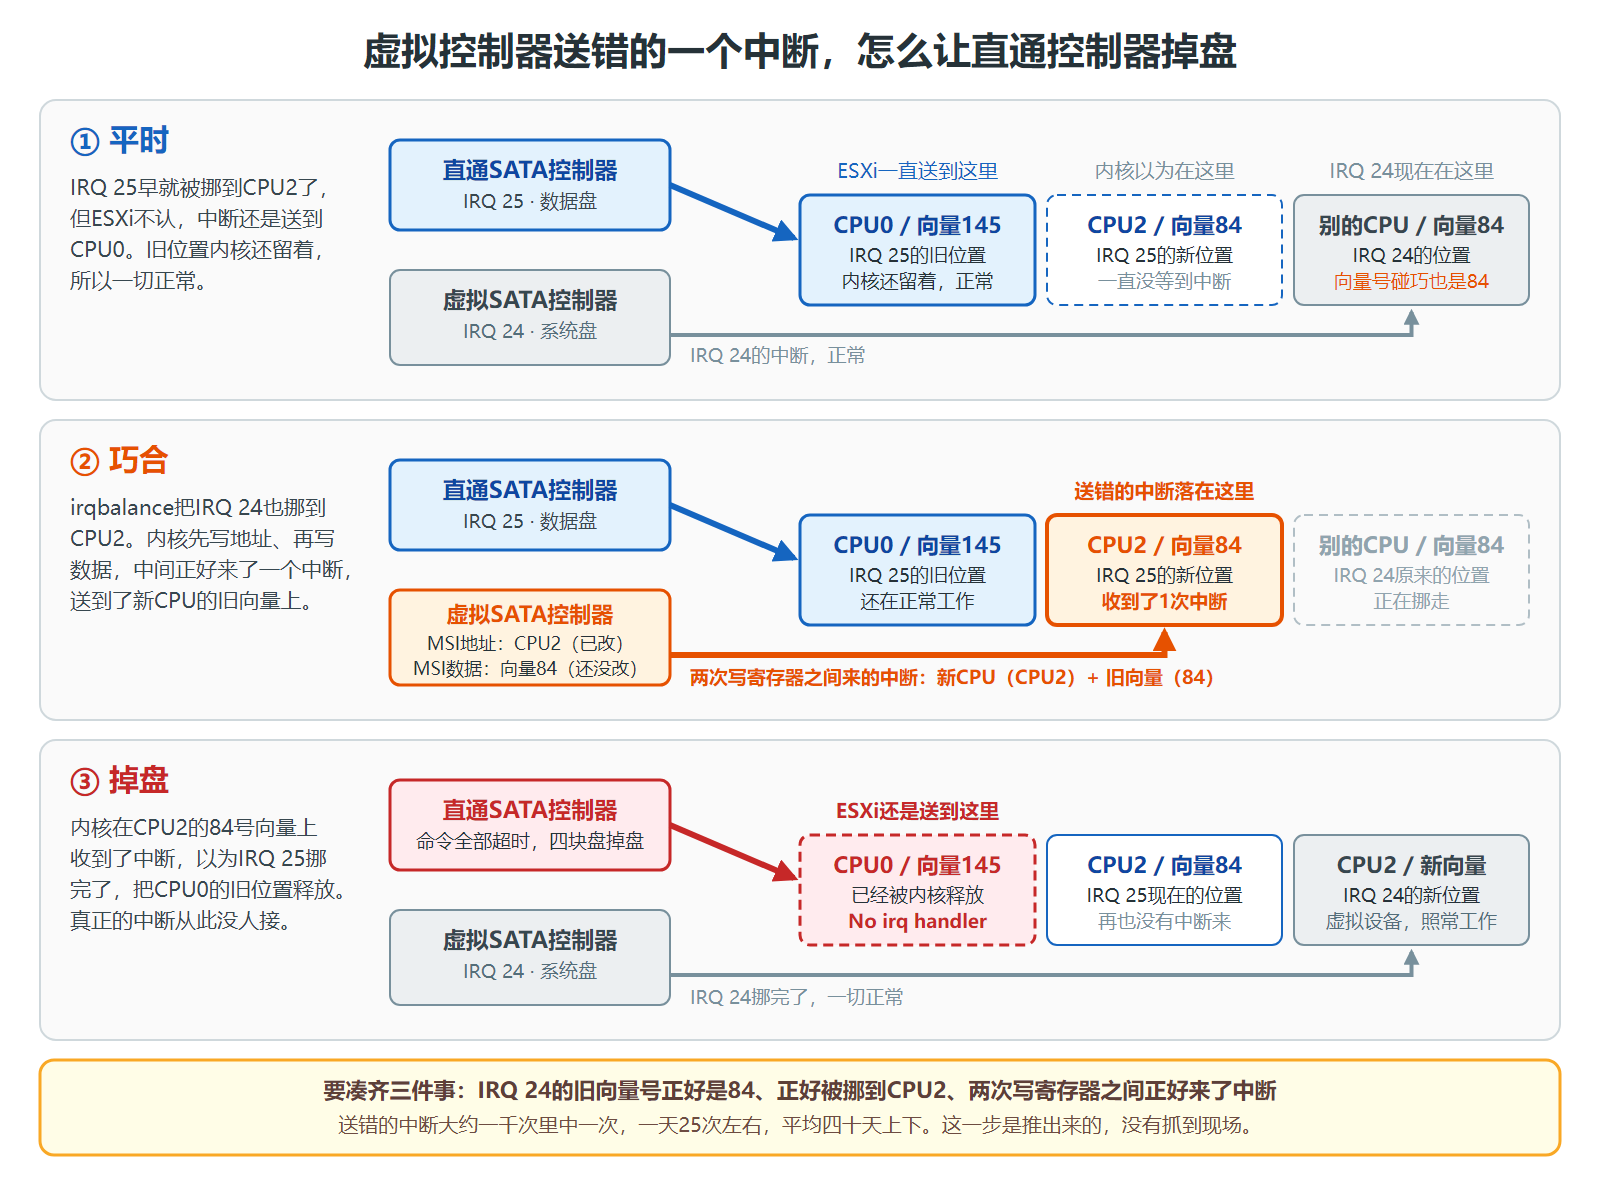
最后这一下我没抓到现场,是推出来的。不过数量上对得上:上次开机的20天里这种记录一共502条,分布在182个不同的向量上,算下来大概一千条里中一次,一天25条左右就是40天上下一次,和实际的间隔(3天到223天,平均74天)是一个量级。
所以完整的经过应该是:
- 开机后irqbalance把IRQ 25从CPU0挪到CPU2,内核改了设备的MSI地址和数据。具体什么时候挪的不知道,可能开机没多久就挪了。
- ESXi不理会这个改动,中断照旧送到CPU0的145号向量。内核的旧向量还留着,所以一直正常。
- 20天后,一个送错的中断正好落在CPU2的84号向量上,内核以为挪完了,把CPU0上的旧向量释放掉。
- 真正的中断还是送到CPU0的145号向量,那里已经没有处理函数,全丢了。
- AHCI驱动等不到中断,命令超时,复位,再超时,最后把端口禁用。四块盘在同一个控制器上共用这一个中断,所以一起掉盘。
间隔这么随机,是因为要等一个送错的中断正好落在那个位置上。
又看了下DSM是怎么启动irqbalance的。启动脚本/usr/syno/etc/rc.sysv/irqbalance.sh会从synoinfo.conf读syno_10g_irq_bind_cpus和syno_ahci_irq_bind_cpus两个值,有的话加上群晖自己的绑核参数。我这个型号的配置里两个都没有,所以就是不带任何参数的irqbalance,所有中断都会被它挪来挪去。
No irq handler这条平时每天都有几十条,每次的CPU和向量都不一样,出现一次就没了;出事那次是同一个0.145一直重复。所以不能光看条数,要看是不是同一个向量在重复:
1 | grep -o 'do_IRQ: [0-9.]* No irq handler' /var/log/kern.log | sort | uniq -c | sort -rn | head |
解决办法
既然ESXi不认改写,那就别让irqbalance去挪这个中断,内核和ESXi认的就一直是开机时的同一个位置,其他中断照常。DSM带的irqbalance是1.6.0,支持--banirq。
中断号写死不太保险,所以写了个脚本启动的时候现查:找出所有不是VMware虚拟设备的AHCI控制器,把它们的中断都ban掉。保存成/usr/local/bin/irqbalance-passthrough-ban.sh,记得chmod 755:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | #!/bin/sh # 启动 irqbalance,但不让它碰直通的 AHCI 控制器的中断 bans="" for dev in /sys/bus/pci/devices/*; do [ "$(cat "$dev/class" 2>/dev/null)" = "0x010601" ] || continue # 只看 AHCI SATA 控制器 [ "$(cat "$dev/vendor" 2>/dev/null)" = "0x15ad" ] && continue # VMware 的虚拟控制器不用管 for irq in $(ls "$dev/msi_irqs" 2>/dev/null) $(cat "$dev/irq" 2>/dev/null); do [ "$irq" -gt 0 ] 2>/dev/null || continue case " $bans " in *" --banirq=$irq "*) ;; *) bans="$bans --banirq=$irq" ;; esac done done # 群晖原脚本里的网卡绑核参数照搬;AHCI 的那个(--synoahciirq)故意不加 options="" ethcpus=$(/usr/syno/bin/synogetkeyvalue /etc.defaults/synoinfo.conf syno_10g_irq_bind_cpus 2>/dev/null) if [ -n "$ethcpus" ] && [ "$ethcpus" -gt 0 ] 2>/dev/null; then options="--synoethirq=${ethcpus}" fi exec /usr/sbin/irqbalance $options $bans |
然后用systemd drop-in把原来的启动命令换掉,/etc/systemd/system/irqbalance.service.d/10-passthrough-ban.conf:
1 2 3 | [Service] ExecStart= ExecStart=/usr/local/bin/irqbalance-passthrough-ban.sh |
1 2 3 4 | systemctl daemon-reload systemctl restart irqbalance cat /proc/$(pidof irqbalance)/cmdline | tr '\0' ' ' # /usr/sbin/irqbalance --banirq=25 |
想确认irqbalance真的认这个参数,可以单独跑一轮调试模式看看:
1 2 | # irqbalance --debug --oneshot --foreground --banirq=25 2>&1 | grep -i ban IRQ 25 was BANNED. |
DSM升级有可能把drop-in清掉,所以又加了个开机检查。DSM开机会执行/usr/local/etc/rc.d/*.sh start,在里面放一个irqbalance-passthrough-ban.sh(也要chmod 755),发现drop-in没了就补回去:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | #!/bin/sh case "${1:-}" in start) dir=/etc/systemd/system/irqbalance.service.d conf=$dir/10-passthrough-ban.conf [ -x /usr/local/bin/irqbalance-passthrough-ban.sh ] || exit 0 if [ ! -f "$conf" ]; then mkdir -p "$dir" printf '%s\n' '[Service]' 'ExecStart=' 'ExecStart=/usr/local/bin/irqbalance-passthrough-ban.sh' > "$conf" systemctl daemon-reload systemctl restart irqbalance logger -t irqbalance-ban "drop-in was missing; re-created it and restarted irqbalance" fi ;; esac exit 0 |
其他几个办法没用:
--banmod=ahci看着更省事,但这个内核给中断起的名字是PCI地址(0000:13:00.0)不是ahci,估计匹配不上,我没试。- 群晖自己的
--synoahciirq是把AHCI中断绑到指定CPU,等于主动挪一次,更不行。 - 直接停掉irqbalance也可以,不过网卡那8个队列的中断就没人管了,只ban一个影响最小。
重启
1 | synoshutdown --reboot |
这是DSM自带的命令,和网页上点重启一样。22:15执行,22:18就能登录了,连不上的时间不到两分钟。起来之后存储池2自己组好了:
1 2 | md3 : active raid5 sata6p5[0] sata3p5[2] sata5p5[1] 23416309760 blocks super 1.2 level 5, 64k chunk, algorithm 2 [3/3] [UUU] |
应该是因为三块盘是一起掉盘的,md想往盘上写谁掉了的时候盘都已经没反应了(DSM日志里那几条write error就是这个),三块盘上的元数据都停在出事之前,是一致的,所以重启直接就能组起来,不用重建。
顺便检查了下:
btrfs device stats /volume2全是0- 四块盘SMART都是PASSED,重映射、待映射、CRC错误都是0
- 原来的账号又能用密钥登了
- 容器都自己起来了
还有一个问题,直通的三块盘离线了两个多小时,开机时DSM系统分区的镜像把它们当成过期的踢掉了(md: kicking non-fresh sata3p1 from array!),存储管理器会提示系统分区故障。数据不受影响,在存储管理器里点修复,几分钟就同步完了。
开机17分钟后再看中断:
1 2 3 | CPU0 CPU1 CPU2 CPU3 CPU4 ... 24: 17115 43475 905 56458 15538 ... 0000:02:02.0 ← 虚拟控制器 25: 110788 0 0 0 0 ... 0000:13:00.0 ← 直通控制器 |
虚拟控制器的中断已经被irqbalance挪了好几个CPU,直通控制器一直在CPU0。No irq handler还是偶尔有(这17分钟里1条,3.120),就是前面说的那种,IRQ 25一直正常,也没有ATA报错。
还不确定的
kern.log只留9份,前五次的内核日志早没了,只能说DSM这边的现象是一样的,不敢保证是同一个原因。- 正好落在预留位置上的那一个中断没抓到现场,是按数量推出来的。
- 最长一次隔了7个月才出现,到底修没修好只能等时间验证。
- 还有一个没试过的办法:在ESXi这边给虚拟机的
.vmx加一行pciPassthru0.msiEnabled = "FALSE",让直通设备不用MSI,退回INTx。ban了以后应该用不上。 - DSM升级以后要看一下irqbalance的命令行里
--banirq还在不在。
如果你也遇到了
ESXi里的Linux虚拟机直通了SATA控制器,偶尔控制器上所有盘一起掉盘、重启就好的,可以这样查:
- 先别重启。密钥登不上的话按上面的办法给root加公钥。
- 看内核日志里是不是链路能up但命令超时,有没有同一个向量反复出现的
No irq handler for vector:
1grep -E 'No irq handler|qc timeout|failed to IDENTIFY|SATA link (up|down)|controller reset failed' /var/log/kern.log | tail -40 - 看
/proc/interrupts里直通控制器的中断是不是都在一个CPU上,而/proc/irq/N/smp_affinity_list指向另一个CPU,再看有没有irqbalance在跑。 lspci -vv看控制器的MSI是不是Maskable-。- 都对得上的话,把这个中断从irqbalance里ban掉再重启。
如果日志里是所有端口一起SATA link down,那是另一回事,该查供电和线。
参考
- x86/apic/msi: Plug non-maskable MSI affinity race(Linux提交6f1a4891a592,2020年):不可屏蔽的MSI改affinity的时候,地址和数据不是一次写完的,中间来的中断会送错地方。前面那些零星的
No irq handler就是这种情况。 - genirq/msi: Make sure PCI MSIs are activated early(Linux提交f3b0946d629c,2016年):提交说明里写了设备可以在MSI使能的时候就把MSI寄存器的内容锁存下来,还提到这个改动顺带修好了VMware直通的一个问题,和这次看到的ESXi的行为对得上。
- irqbalance:
--banirq这些参数的说明。

0 评论